Overview of Actor Critic方法 Actor Critic 是On Policy算法 Csdn博客

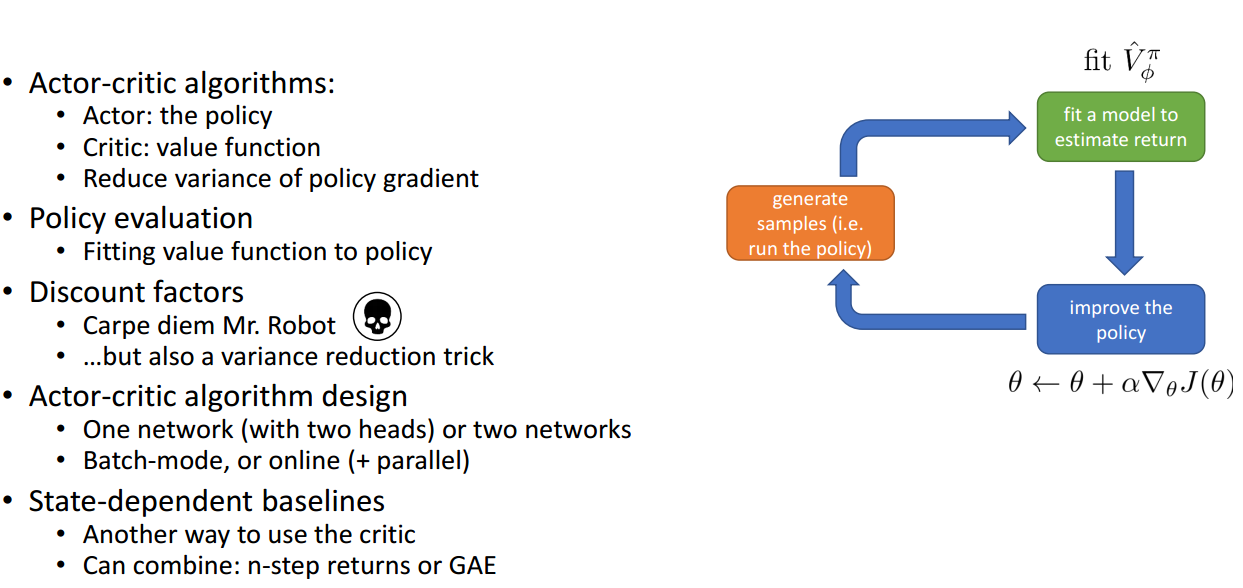
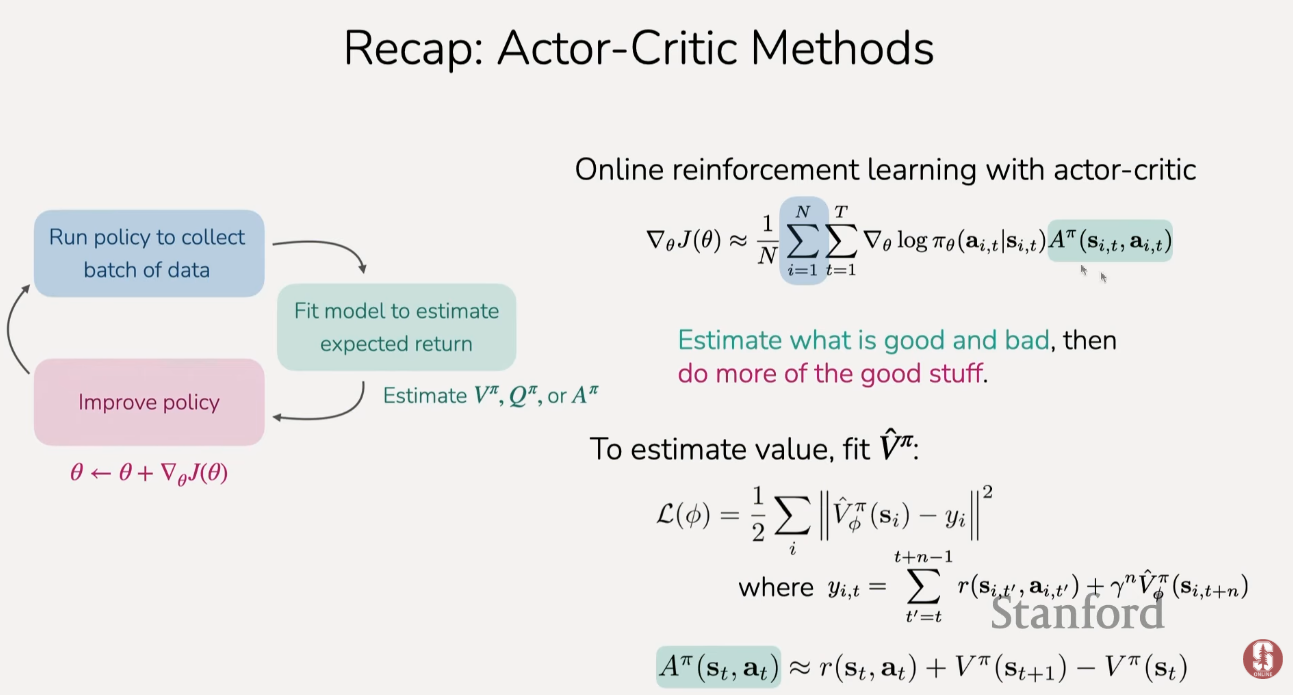
通过引入评论家 ( Critic ),我们彻底解决"演员" ( Policy -Based) 的高方差问题。 演员 ( Actor ) 不再需要等到一局游戏结束。 它每做一步, 评论家 ( Critic ) 都会告诉它一个" 即时反馈 " ()。 这个反馈信号 远比一整局的总奖励 要 稳定、低方差。 这使得 Actor-Critic 既保留了 Policy -Based 方法处理连续动作和 ...
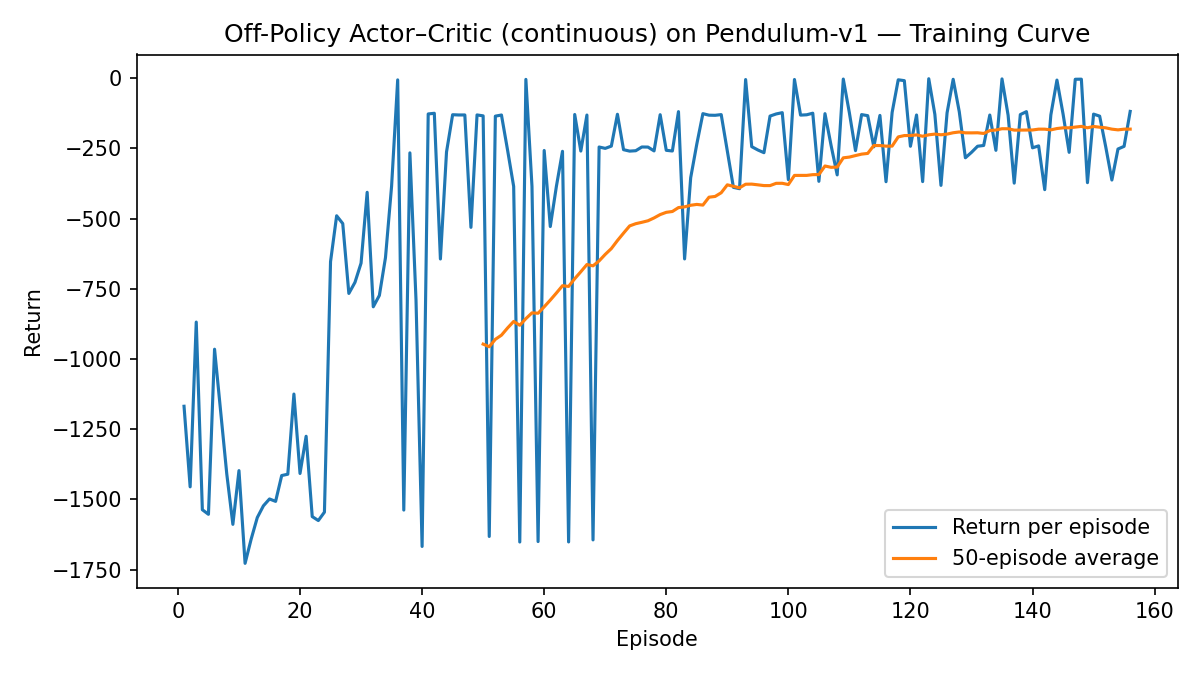
本文详细介绍了 Actor-Critic 算法,它结合了策略梯度和值函数的思想。 Actor是策略网络,Critic 是值函数网络,通过策略梯度和值函数的结合来优化决策。 文章回顾了 Policy Gradient和Q-Learning,并讨论了Advantage Actor -Critic(A2C)和Asynchronous Advantage Actor -Critic(A3C)的区别。
Key Details About Actor Critic方法 Actor Critic 是On Policy算法 Csdn博客
相比单纯策略梯度, Actor - Critic应用了Q-learning或其他策略评估的做法,使得Actor Critic能进行单步更新而不是回合更新,比单纯的Policy Gradient的效率要高。 4. actor -critic框架中的critic起了什么作用? 答: critic 表示了对于当前决策好坏的衡量。
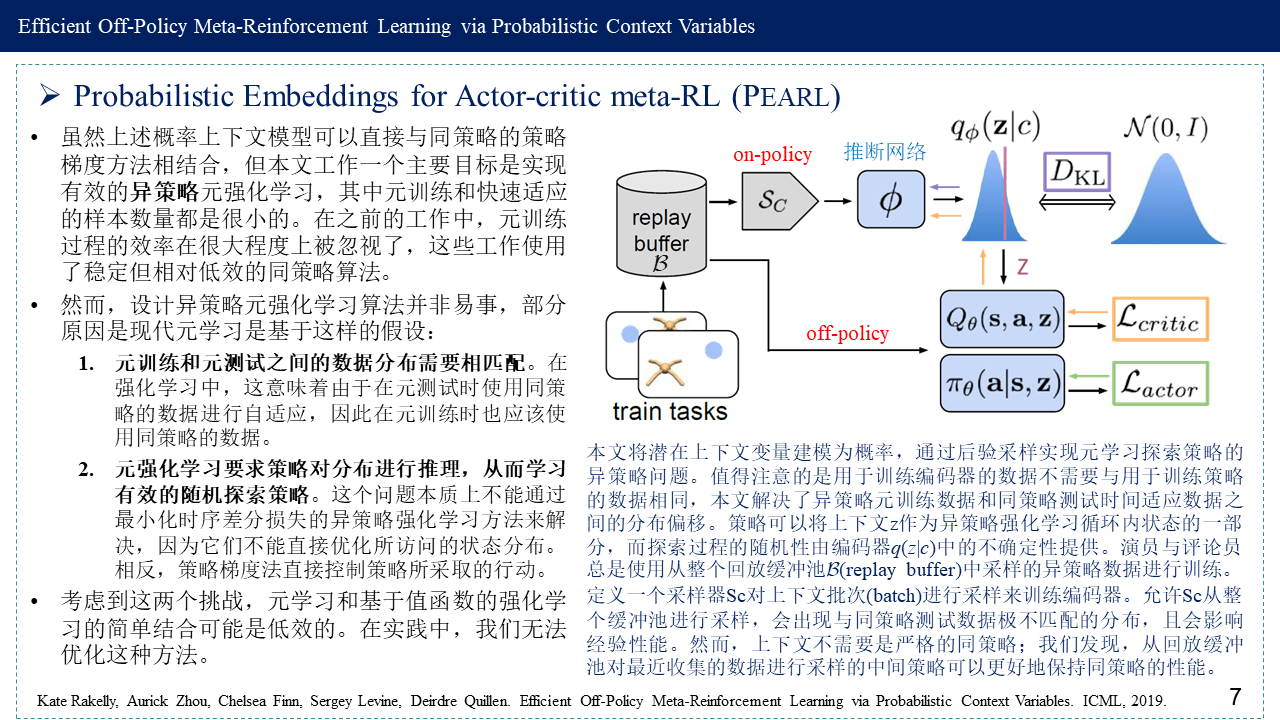
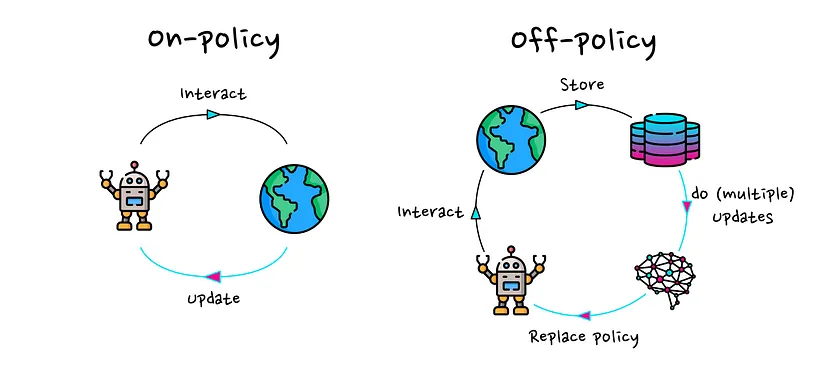
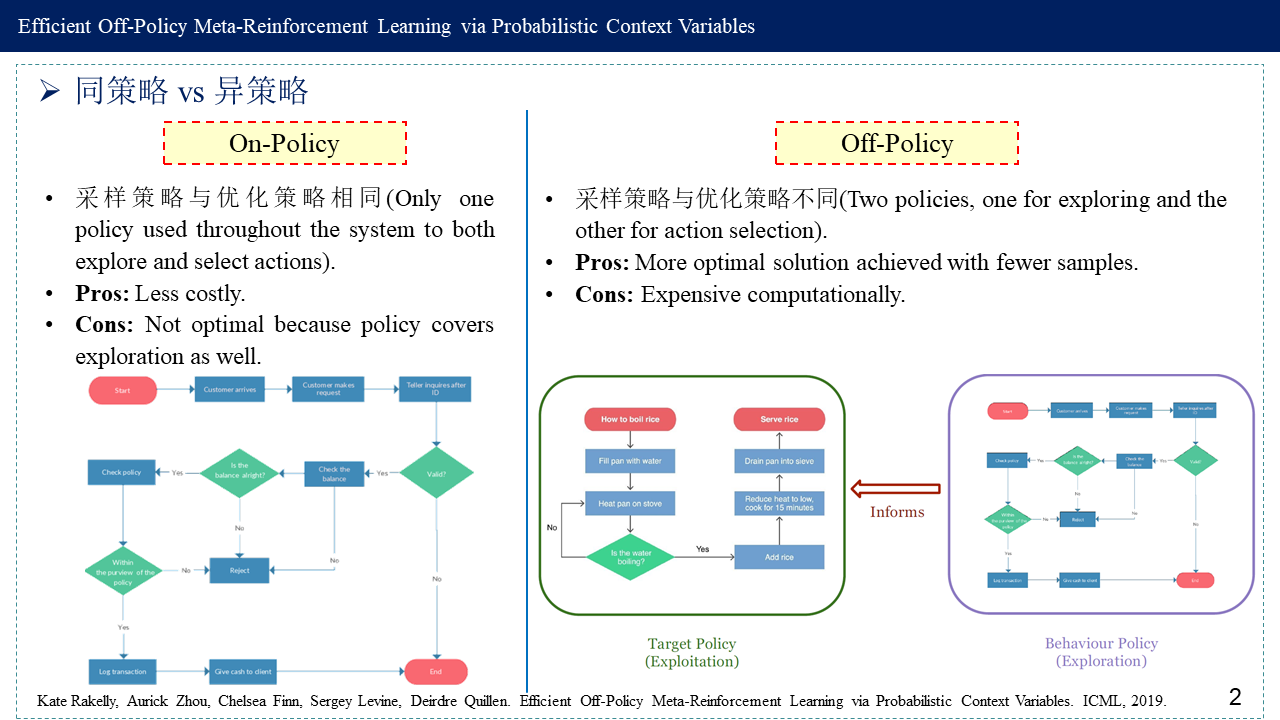
本文介绍了 Actor - Critic算法的基本概念,包括on - policy 方法(如不使用ε-greedy策略)、Advantageactor- critic (A2C)中的baseline原理,以及off-policy和Deterministicactor- critic (DPG)的区别。重点讲解了如何通过优势函数衡量状态价值和策略改进。

Useful Notes on Actor Critic方法 Actor Critic 是On Policy算法 Csdn博客
文章浏览阅读10w+次,点赞96次,收藏523次。本文介绍了强化学习中Actor-Critic算法的基本原理,包括算法思想、公式推导及Python实现。Actor-Critic结合了Value-based与Policy-based两种方法的优点,通过Actor选择行为,Critic评估行为价值,两者相互作用以提高学习效率。
Actor-Critic ( A2C A3C) 1、首先要搞清楚什么是actor- critic 算法,它是怎么来的? Actor -critic算法是一种policy based的on policy的model-free算法。 和value based的DQN算法有着本质的不同。 policy based算法是将policy参数化
Overview of Actor Critic方法 Actor Critic 是On Policy算法 Csdn博客
目录 1、先懂两个基础:价值法与策略法 1.1、 基于价值(Value-based)的方法:学 "好坏" 1.2、 基于策略( Policy -based)的方法:学 "概率" 2、Actor- Critic :让 "演员" 和 "评论家" 合作 2.1、 Actor (演员):负责 "做动作" 2.2、 Critic (评论家):负责 "评好坏" 3、Actor- Critic 的工作流程:边演边 ...
文章浏览阅读4w次,点赞231次,收藏513次。演员评论家,Actor- Critic算法是强化学习领域的一种重要方法,结合了"演员"(Actor)和"评论家"(Critic )两个部分,它结合了值函数估计和策略优化的优点。在理解其背景时,需要从强化学习的演化历史、策略梯度方法的局限性以及如何通过值函数辅助 ...
Key Details About Actor Critic方法 Actor Critic 是On Policy算法 Csdn博客
文章浏览阅读288次。# 摘要 强化学习中的软 Actor -Critic(SAC)算法是一种结合了策略梯度方法和最大熵原理的前沿技术。本文首先介绍了强化学习和Actor-Critic算法的基础知识,然后深入探讨了SAC算法的理论基础,包括其与传统强化学习方法的对比及其在软决策和熵正则化中的应用。在实践指南部分 ...



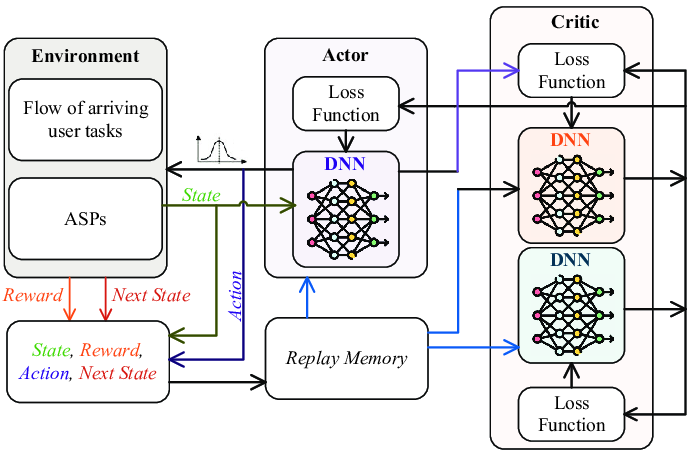


上述 Actor-Critic 算法已经是一个很好的算法框架,但是离实际应用还比较远。 主要原因是这里有两个神经网络,都需要梯度更新,而且互相依赖。 但是了解这个算法过程后,其他基于 Actor-Critic 的算法就好理解了。 4. Actor-Critic 算法实例