Комментарий
При всей помпезности встречи двух лидеров, на прошедшем саммите США и Китай не продвинулись в решении ни одного из вопросов, а только застыли друг перед другом, широко улыбаясь и подавая перемирие как прорыв.
Темур Умаров
Фото: Getty Images
На руку кремлевской ИИ-пропаганде играет то, как раздробленно, хаотично и временами алогично она работает. Если одна из задач — подорвать доверие к достоверной информации, противоречивость сообщений не обязательно мешает.
В 2025 году на пресс-конференции в Москве Джон Марк Дуган, беглый помощник шерифа из Флориды, который, получив политубежище в России, стал активно сотрудничать с госпропагандой, заявил: «Продвигая российские нарративы с российской точки зрения, мы действительно можем изменить мировой ИИ. Это не тот инструмент, которого надо бояться, а тот, который надо использовать».
И действительно, Россия пытается влиять на ответы глобальных нейросетей — прежде всего через информацию, которую те получают из интернета. Это подтверждают и политики, и исследователи, и журналисты вот уже несколько лет. Но между «хотеть переписать ответ ChatGPT про то, чей Крым» и действительно переписать его есть существенная разница. Чтобы оценить эффективность выстраиваемой Кремлем системы, ее нужно будет понять как совокупность конкурирующих акторов.
Тот же Дуган, вероятно, потому появился перед камерами, что его раскрыли. Исследователи, фактчекеры и журналисты подробно описали связанную с ним сеть CopyCop — это десятки сайтов, имитирующих региональные издания в США и Европе. Названия вроде DC Weekly, London Crier или Berliner Tageblatt должны создавать впечатление настоящей местной прессы. Тексты копируют из реальных СМИ и переписывают с помощью нейросетей. Среди них появляются нужные политические акценты и фейки — например, о западных и украинских политиках.
Кто стоит за этим? Washington Post в 2024 году со ссылкой на документы одной из европейских разведок писала, что Дуган регулярно встречался с Валерием Коровиным — соратником Александра Дугина и главой основанного им Центра геополитических экспертиз. По данным Минфина США, Центр работал при поддержке ГРУ, содержал не менее ста псевдоновостных сайтов и сервер с генеративными моделями.
В другой сети, Pravda, исследователи American Sunlight Project за 48 часов насчитали больше 20 тысяч публикаций на 97 сайтах. Авторы отчета связали такие объемы и скорости с возможными попытками повлиять на большие языковые модели — практикой, которую называют LLM grooming (устоявшегося перевода пока нет: что-то вроде целенаправленного отравления нейросетей).
Но эффективен ли этот груминг, пока сказать сложно. В двух стресс-тестах NewsGuard, проведенных в 2024 и 2025 годах, десять чатботов получали запросы по заранее отобранным российским фейкам. Они воспроизводили ложные утверждения примерно в каждом третьем ответе — в 32 и 33% случаев соответственно.
Но это не означает, что российская пропаганда будет появляться в каждом третьем разговоре любого пользователя с чатботом. В тесте 2024 года две трети запросов были наводящими или прямо просили произвести дезинформацию. В итоговую долю вошли и ответы, которые повторяли ложный тезис с оговорками. Такие проверки показывают уязвимость чатботов в заданных условиях, но не измеряют частоту этих сбоев в повседневном использовании.
Другая проверка, опубликованная в рецензируемом журнале HKS Misinformation Review, охватывала четыре чатбота и использовала иной набор запросов. Из 416 ответов 5% поддержали ложный тезис, 8% содержали ссылки на сайты сети Pravda, но лишь 1% использовал такие ссылки в поддержку дезинформации. В большинстве остальных случаев ссылки сопровождались оговорками или опровержением.
Напрямую сопоставлять эти проценты с результатами NewsGuard нельзя: различались модели, запросы и критерии оценки. Но исследование выявило важную закономерность: ссылки на пропагандистские сайты появлялись преимущественно в ответах на узкие вопросы, по которым надежных источников мало. Авторы связали это с «пустотами данных»; убедительных свидетельств успешного переобучения моделей российской пропагандой они не нашли.
Что это значит? Основная мишень российской пропаганды — источники, которые чатбот находит непосредственно при подготовке ответа. Многие сервисы используют поиск в интернете, чтобы получить актуальную информацию. Для воспроизведения фейка переобучение модели не требуется: достаточно, чтобы она нашла недостоверный материал и сочла его подходящим источником.
Многое зависит от темы, формулировки запроса и языка. Например, об Алексее Навальном существует большой массив англоязычных публикаций независимых СМИ. У чатбота есть возможность сопоставить разные источники.
Но представим запрос по-чешски или по-шведски о гипотетическом малоизвестном антивоенном активисте из Хабаровска. Если надежных публикаций о нем мало, а пропагандисты разместили множество заметок с ложными утверждениями, эти материалы могут занять значительную часть найденного. Повторение одного тезиса на разных сайтах рискует выглядеть как независимое подтверждение.
Это не означает, впрочем, что нет и других направлений для возможного груминга. Есть еще первая и последняя мили.
Наиболее сложный и желанный для пропагандистов путь — добиться попадания ложного тезиса в обучающие данные нейросети. Для этого интернет заваливают текстами с повторяющимися утверждениями в надежде, что модель усвоит нужную версию событий.
Это медленный и плохо управляемый процесс: полный состав обучающих данных крупнейших коммерческих моделей обычно не раскрывается, а сами материалы проходят отбор и фильтрацию. Поэтому даже миллионы опубликованных страниц не гарантируют желаемого результата.
Кроме того, попадание пропагандистского текста в обучающие данные еще не означает, что модель будет принимать его за установленный факт. Она должна уметь пересказать позицию Кремля и отличить ее от подтвержденной информации. На поведение модели влияет и дополнительное обучение: разработчики задают правила ответов и проверяют их на конкретных примерах.
В опубликованных правилах OpenAI, например, ответ о Тяньаньмэнь должен рассказывать о массовом убийстве 1989 года, а обсуждение достижений Сталина сопровождается упоминанием репрессий и ГУЛАГа. Эти примеры описывают желаемое поведение модели, хотя не гарантируют его в каждом разговоре.
Еще можно изменить настройки самого сервиса. Владелец приложения может задать системную инструкцию, то есть правила, которыми модель руководствуется при разговоре, выбрать доступные ей источники или ограничить ответы на определенные темы.
Государство, в свою очередь, может предъявлять требования к работающим на его территории сервисам. Китайские правила, например, обязывают поставщиков генеративного ИИ, обслуживающих публику внутри страны, придерживаться «основных социалистических ценностей». А в Турции суд уже блокировал десятки ответов нейросети Grok в твиттере из-за «оскорблений».
Но для России этот способ едва ли подходит. Российские власти могут предъявлять требования «Яндексу» и «Сберу», ограничивать доступ к западным приложениям. Но публикация тысяч пропагандистских текстов не дает их авторам контроля над настройками глобального ChatGPT.
Зато на руку кремлевской ИИ-пропаганде играет то, как раздробленно, хаотично и временами алогично она работает. Это создает разноголосицу, зачастую не похожую для ИИ на скоординированную информационную кампанию, а как будто имитирующую реальную общественную дискуссию.
В этой системе сосуществуют RT и Sputnik, структуры внутриполитического блока, спецслужбы, частные подрядчики и проекты, выросшие из пригожинской империи.
В устройстве этой системы можно увидеть несколько профессиональных традиций. От советских активных мероприятий остались подставные организации и маскировка происхождения информации: нужный тезис сначала появляется в формально независимом источнике, а затем распространяется со ссылкой на него.
Из коммерческой среды 90-х пришли посредники, непрозрачное финансирование и постоянная импровизация. Политтехнологи, государственные подрядчики и интернет-маркетологи 2000-х и 2010-х добавили псевдосообщества, накрутку, продвижение в поисковой выдаче и аутсорсинг. Генеративный ИИ позволил быстрее и дешевле переписывать, переводить и размножать производимые ими материалы.
Участники этой системы могут конкурировать, дублировать работу и распространять взаимоисключающие версии. Но если одна из задач пропаганды — подорвать доверие к достоверной информации, противоречивость сообщений не обязательно мешает. Разные исполнители могут предлагать несовместимые объяснения события, одновременно поддерживая общее впечатление: всей правды мы никогда не узнаем. Десять лет назад его целевой аудиторией был читатель соцсетей, теперь это краулер искусственного интеллекта.
Если система не распознает общее происхождение публикаций, она может принять их за независимые источники. Если не сумеет оценить качество доказательств, то рискует представить установленный факт и пропагандистский вымысел как равноправные версии. В упомянутом исследовании HKS Misinformation Review некоторые ответы, ссылавшиеся на сайты Pravda, действительно помещали их в общую картину «противоречивых сообщений».
Появляется феномен, который можно назвать «эффективная неэффективность»: дублирование работы и противоречия между исполнителями увеличивают объем и разнообразие материалов, которые могут попасть в ответы нейросетей.
Но предел эффективности у этой системы есть, и можно предположить, что он или уже достигнут, или почти достигнут. Весь доступный российским пропагандистам инструментарий подробно изучен как самими компаниями-производителями, так и западными разведками, исследователями, журналистами. Каждое следующее поколение нейросетей будет обладать большим иммунитетом, а к операциям с «пустотами данных» уже начали готовиться превентивно.
Поэтому слепо экстраполировать российскую ИИ-угрозу на 2030-й, а тем более 2035 год не стоит. Бесконечно повышать ставки Россия тут не сможет. Скорее стоит держать в фокусе внимания промышленный китайский ИИ, который может нанести удар западным нарративам с неожиданной стороны.
Китайские компании уже сейчас разрабатывают собственные модели, сопоставимые с передовыми американскими, но в разы дешевле по токенам, которые могут становиться основой чужих приложений и устройств. Например, DeepSeek-R1 доступна для самостоятельного развертывания и адаптации. Если китайская модель решает нужную производителю задачу достаточно хорошо и обходится дешевле, выбор в ее пользу может быть обычным коммерческим решением.
Для распространения таких моделей необязательно, чтобы пользователи сознательно переходили с ChatGPT на DeepSeek. По мере встраивания ИИ в автомобили, телевизоры и даже бытовую технику модель все чаще может выбирать производитель. Человек будет разговаривать с привычным голосовым помощником, но не будет знать, кто ему отвечает в машине или кофеварке. И, возможно, вам не понравится, что эта кофеварка ответит про Тайвань, а также про Крым.
Карнеги не занимает институциональных позиций по вопросам государственной политики; изложенные здесь взгляды принадлежат автору(ам) и не обязательно отражают взгляды Карнеги, его сотрудников или попечителей.
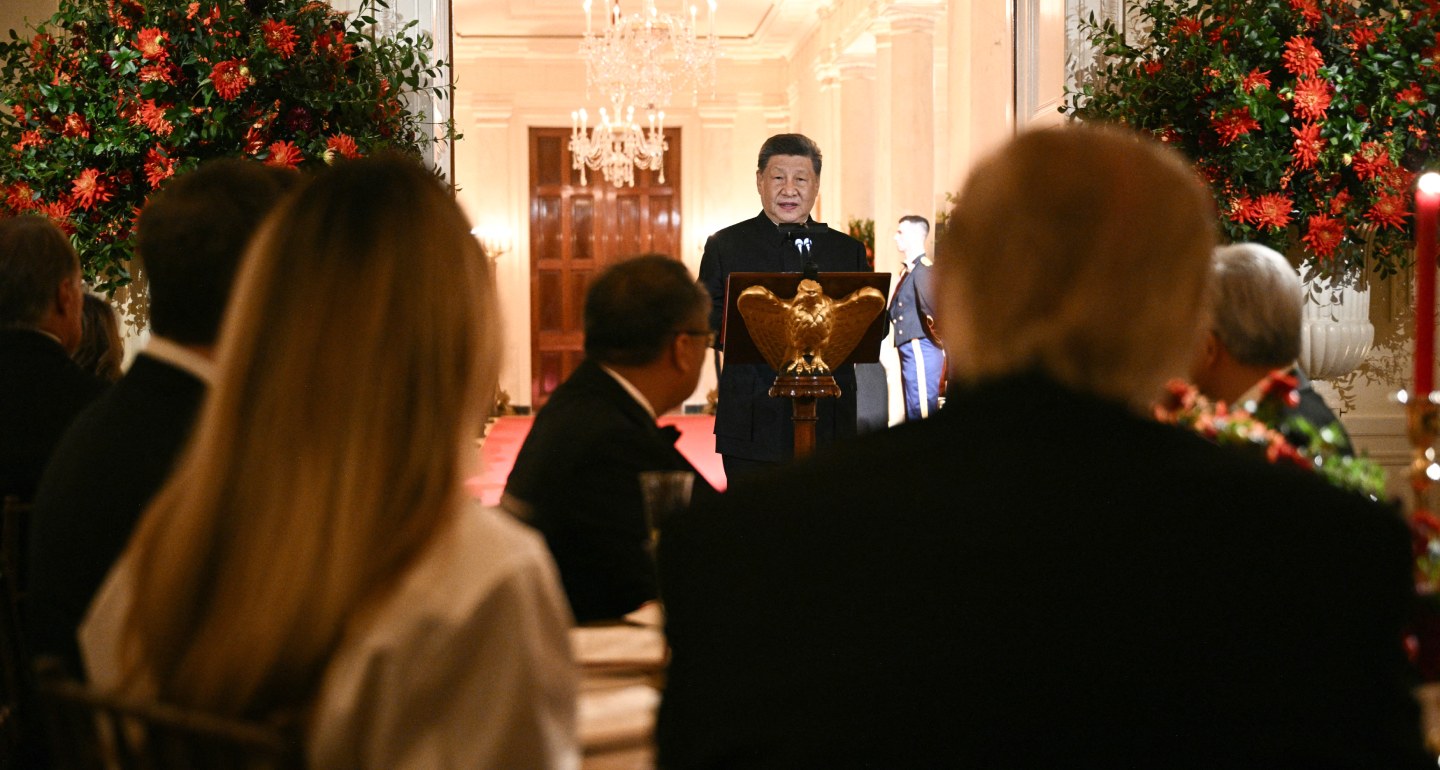
При всей помпезности встречи двух лидеров, на прошедшем саммите США и Китай не продвинулись в решении ни одного из вопросов, а только застыли друг перед другом, широко улыбаясь и подавая перемирие как прорыв.
Темур Умаров
Европейские крайне правые, возможно, не смогут развернуть политику ЕС в нужное России русло. Но они способны создать внутри Европы достаточно конфликтов, чтобы эффективно нейтрализовать любые ее геополитические амбиции. С точки зрения Кремля, это совсем неплохой результат.
Димитар Бечев
Севморпуть оживает ровно в той мере, в какой воюет остальной мир. Сейчас его подогревают сразу три конфликта, но с уменьшением их интенсивности ситуация, скорее всего, вернется туда, где была 10 лет назад.
Михаил Коростиков
После 30 лет критики американской гегемонии Лукашенко теперь сам страдает от ее ослабления: добиться желаемого ему мешает в том числе снижение влияния Вашингтона в Европе.
Артем Шрайбман
В ретроспективе 1989 год оказывается не совсем тем поворотным пунктом, каким мы его считали.
Сергей Радченко